Ein Käfig, der auf ein Nein wartet
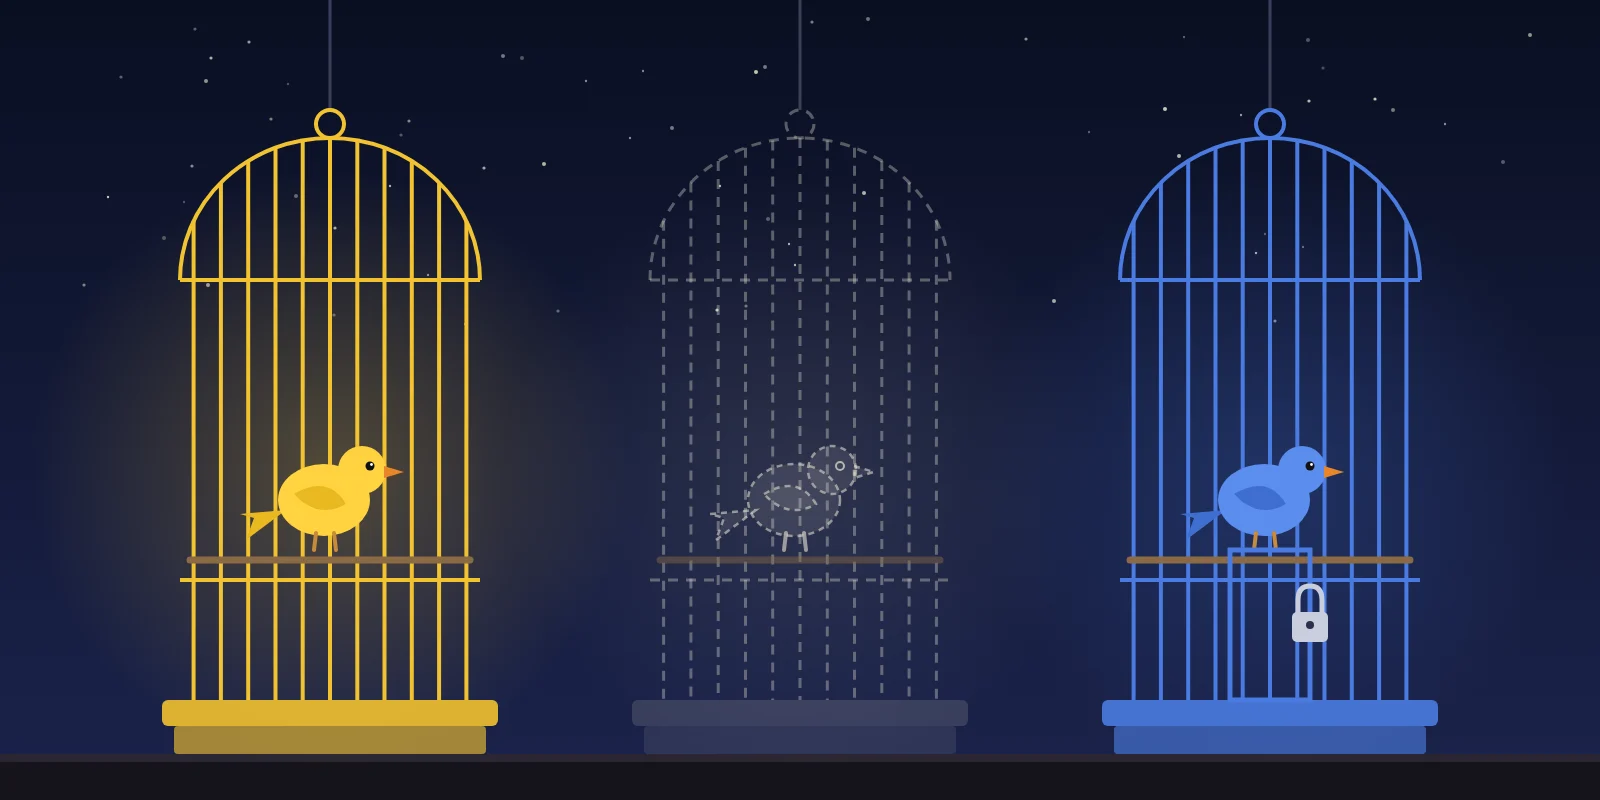
Der gelbe und der durchsichtige Käfig sind offen: Ihre Wörter dürfen zum Training von KI-Modellen verwendet werden. Der blaue Käfig soll das Gegenteil prüfen. Hier steht ein ausdrückliches Nein zum Training, und die Frage ist, ob sich die Anbieter daran halten.
Geplantes Signal in der robots.txt: User-Agent: __usage_ai-training, Disallow
Öffnet, sobald OpenAI das Signal nachweislich beachtet
Teil eines Versuchs mit mehreren Käfigen.
Was gerade passiert
Lange gab es kein gemeinsames Nein. Jede Firma hatte ihren eigenen Schalter in der robots.txt: Google nennt ihn Google-Extended, Apple Applebot-Extended, OpenAI GPTBot, Anthropic ClaudeBot. Wer sein Werk vom Training ausschließen wollte, musste jede Firma einzeln aussperren.
Seit 2025 arbeitet eine Arbeitsgruppe der IETF an einer gemeinsamen Sprache für solche Wünsche. Die IETF ist das Gremium, das die technischen Regeln des Internets festlegt. Ihre Entwürfe sind noch nicht fertig.
Am 30. Oktober 2026 kam Bewegung in die Sache. Anthropic, Google, Microsoft und OpenAI haben angekündigt, ein gemeinsames Signal zu beachten: eine eigene Zeile in der robots.txt, die nur eines sagt. Diese Seiten bitte nicht zum Training von KI-Modellen verwenden. Es ist kein Verbot, die Seite zu lesen, sondern ein Wunsch, wie das Gelesene verwendet wird.
Die Umsetzung kommt Schritt für Schritt. Anthropic sagt, es habe damit bereits begonnen. OpenAI will in den kommenden Monaten folgen, Microsoft ab Februar 2027, Google im Laufe des Jahres 2027. Apple, Meta und Perplexity haben bisher nichts zugesagt.
Zwei Einschränkungen bleiben. Das Signal ist freiwillig, niemand kann es technisch erzwingen. Und es wirkt nur nach vorn: Was schon gesammelt wurde, bleibt gesammelt.
Europa ist schon weiter
In der EU ist ein Nein zum Training mehr als eine höfliche Bitte. Rechteinhaber dürfen verbieten, dass ihre Werke für kommerzielle Zwecke automatisch ausgewertet werden. In Deutschland steht das seit 2021 im Urheberrechtsgesetz. Die Bedingung: Das Verbot muss maschinenlesbar sein.
Der EU AI Act verpflichtet die Anbieter großer KI-Modelle seit August 2025, solche Verbote zu beachten. Seit August 2026 kann das KI-Büro der EU das mit Bußgeldern durchsetzen. Die meisten großen Anbieter haben dazu einen freiwilligen Verhaltenskodex unterschrieben, der die robots.txt ausdrücklich nennt. Meta hat ihn nicht unterschrieben.
Wie genau die Gerichte hinschauen, zeigt ein Fall aus Hamburg. Ein Fotograf wollte nicht, dass seine Bilder zum Training verwendet werden. Das Verbot stand aber nur in normaler Sprache in den Nutzungsbedingungen. Das Oberlandesgericht Hamburg entschied Ende 2025: Das reicht nicht, ein Verbot muss für Maschinen lesbar sein.
Dass Training Spuren hinterlässt, hat das Landgericht München im November 2025 festgestellt. ChatGPT konnte Liedtexte wiedergeben, die es beim Training gelernt hatte. Die GEMA hatte geklagt, und das Gericht sah darin eine Verletzung des Urheberrechts. Genau solche Spuren sucht auch dieser Versuch, nur mit erfundenen Wörtern statt mit Liedtexten.
Warum der Käfig noch zu ist
Die Zusagen sind da, die Umsetzung noch nicht. Ein fairer Test braucht einen Anbieter, der das Nein wirklich beachtet. Sonst zeigt ein Treffer nur, dass er etwas gelernt hat, was er zu diesem Zeitpunkt noch lernen durfte.
Deshalb bleibt dieser Käfig leer, bis OpenAI das Signal nachweislich beachtet. Dann kommen die Wörter, und ab diesem Tag läuft die Uhr. Für jeden weiteren Anbieter zählt der Tag, an dem er das Signal umsetzt.